OpenAIがHabitatの設計を公開、AIの使い心地を支えるデータ基盤とは
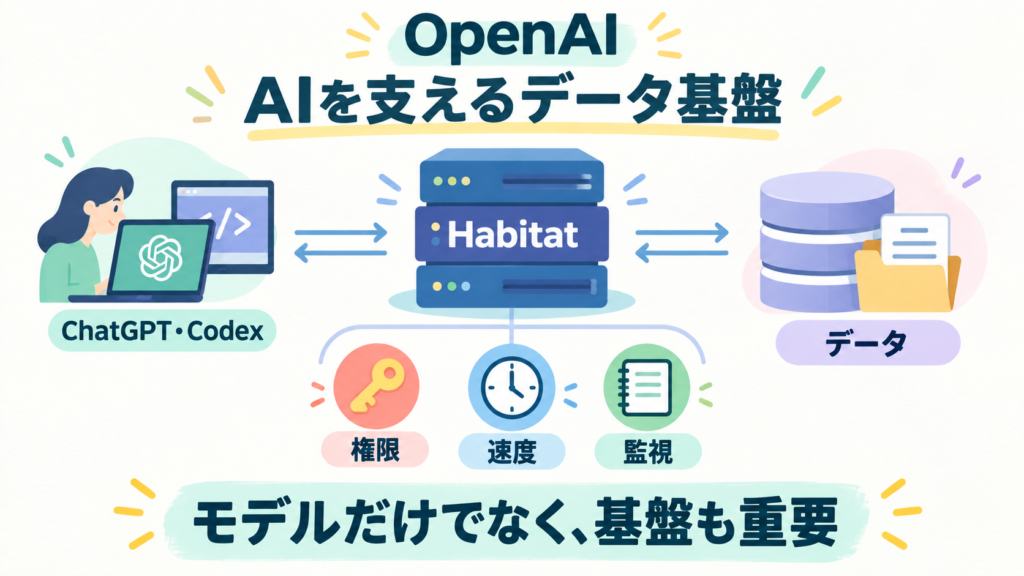
OpenAIは9月11日、ChatGPTやCodexを支えるオンラインデータ基盤「Habitat」の設計と拡張の経緯を公開しました。新モデルの発売ではなく、急増する利用を支える裏側の技術解説です。AIの応答体験はモデルの賢さだけでなく、必要な情報を素早く、安全に取り出せる仕組みにも左右されることが分かります。
製品ごとの更新から共通基盤へ
Habitatは、各製品がデータを保存・取得するときの共通基盤です。出発点はPython製の小さなライブラリでしたが、製品やサービスが増えると、それぞれの更新を調整する負担が大きくなりました。同社はデータ処理を独立したサービスへ移し、変更や監視を共通の場所で扱う構成にしたと説明しています。
速度とデータ保護を一緒に管理
共通化の目的は速度だけではありません。アクセス権限の確認や監査記録を集約し、利用者のデータへの不正なアクセスを防ぐ役割もあります。一方、処理を集約するだけで問題が解決するわけではなく、負荷が一部に偏ることや、応答が特に遅い処理への対策も必要になりました。
AI導入では周辺の仕組みも確認
企業がAIサービスを導入する際も、モデル選びと同時に、接続先の権限や障害時の動き、遅延の監視を確認する視点が役立ちます。回答が遅い原因をすべてAIモデルに帰すのではなく、周辺のデータ取得まで切り分けることで、改善すべき場所を見つけやすくなると考えられます。 今回公開されたのはOpenAI自身による運用事例です。一般向けにHabitatを販売する発表や、すべての障害を防げるという保証ではありません。大規模な設計をそのまま小さなサービスへ移す必要はなく、自社の利用量と管理できる範囲に合わせて参考にすることが大切です。