Google Researchが検索向け軽量モデルを提案、推論時の待ち時間を抑える
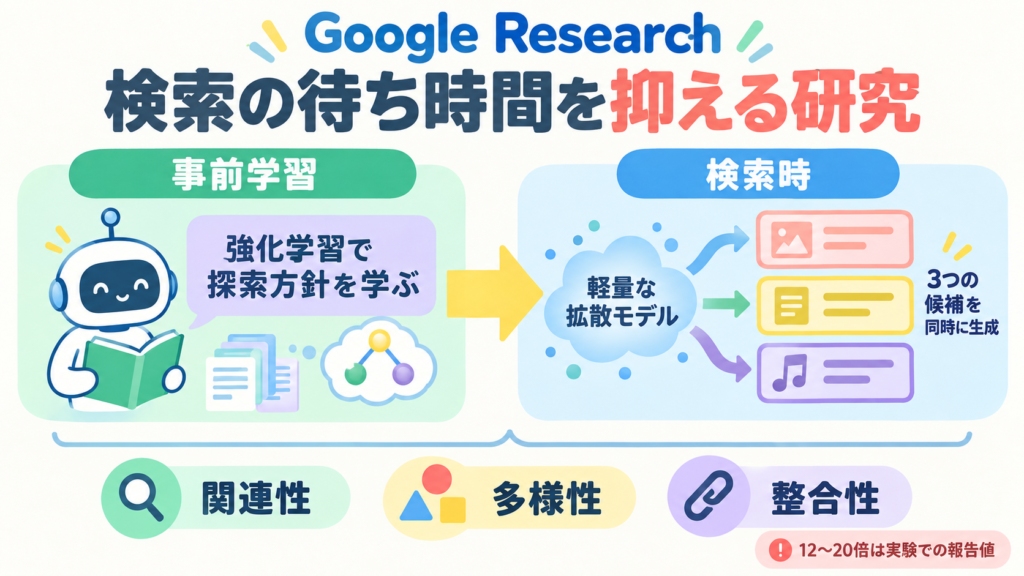
Google Researchは9月15日、複数の候補をまとめて探すAI検索を高速化する「Retrieve-for-Train」を発表しました。重い探索を利用時に毎回行うのではなく、強化学習で得た探索方針を事前学習へ移し、軽量な拡散モデルで一度に候補を出す考え方です。研究結果では、自己回帰型の手法より12〜20倍の高速化を報告しています。実サービスの効果はデータや目的に左右されるため、研究結果と製品性能は分けて見る必要があります。
検索時に考え続ける負荷を、学習へ移す
複雑な検索では、一つの質問から複数の関連質問を作り、幅広く候補を集める「fan-out」が使われます。しかし、汎用LLMにその場で考えさせると、似た質問ばかりになることや、推論トークンによる待ち時間が課題になります。今回の研究は、検索時の考える量を減らす方法を提案しました。
関連性・多様性・整合性をまとめて評価
まず強化学習で、関連性、候補の多様性、元の質問との整合性を満たす探索を学びます。次に、その結果を教師データにして、5,390万パラメータの拡散型検索モデルを学習します。利用時は、候補の埋め込みを並列に生成するため、文章を順番に生成する方式より待ち時間を抑える設計です。
12〜20倍は実験条件での報告値
検索や推薦では、単に最上位の一件を返すだけでなく、重複しない候補群を素早く出すことが価値になります。商品、画像、音楽などのデータベースを扱うチームは、モデルの大きさだけでなく、候補の多様性、検索対象への適合、応答時間を一緒に評価する視点が持てます。 報告された速度差は、同社の実験条件での結果です。特定のデータセットやモデル構成に依存するため、別の検索サービスで同じ数値が出る保証はありません。人間の判断を不要にする技術ではなく、検索の候補を作る工程を効率化する研究です。