低資源言語の音声AIへ共同投資、使える言語を増やすにはデータと権利が要る
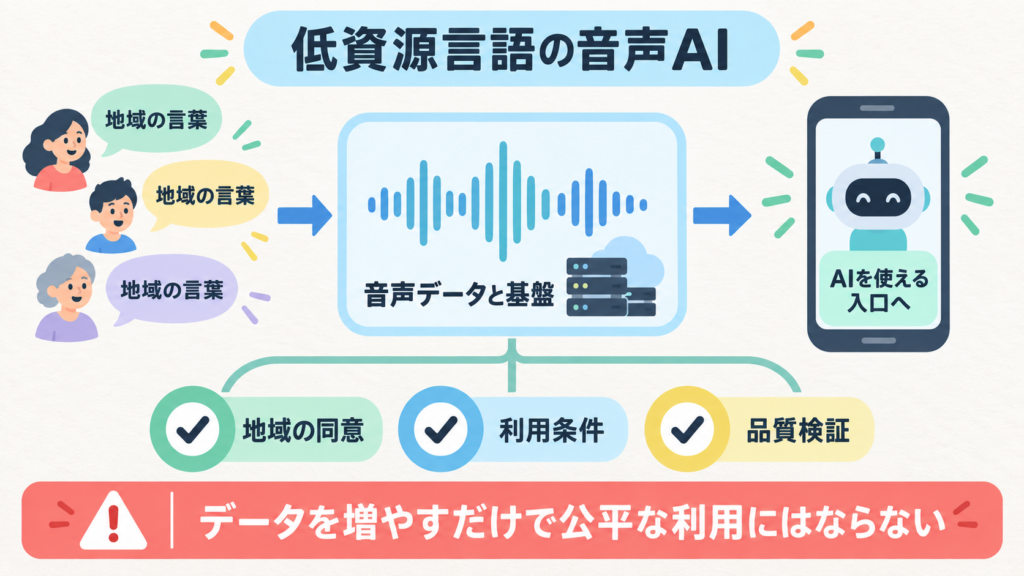
OpenAI Foundationは9月21日、Gates Foundationなどと、AIで十分に扱われない言語を対象にした共同取り組みへ参加すると発表しました。音声AIのデータと基盤に焦点を置き、投資だけでは整いにくい言語の性能向上を目指します。多言語対応は翻訳画面を増やすだけの課題ではなく、地域の話し方を含むデータを、誰の同意と管理の下で集め、検証するかが重要です。参加表明は、全言語で同じ品質になることを意味しません。
音声AIから言語の利用格差を縮める
OpenAI Foundationは、Gates Foundationと世界の組織が進める、AIが世界の言語で機能するための共同コミットメントに加わったと説明しています。初期の対象は音声AIで、低資源言語におけるデータやインフラの不足を埋める方針です。Gates Foundationの発表では、初期の大規模言語モデルの学習データの多くが英語由来だったことを、利用格差の背景として挙げています。
データ量だけでなく同意と検証を設計する
音声は多くの人にとって自然な技術の入口ですが、言語や方言ごとに十分なデータがなければ、認識や応答の品質は安定しません。データを増やすだけでなく、地域が扱いを理解し、利用条件や検証に参加できることが重要です。誤変換が医療、教育、行政の案内で起きれば、単なる使いにくさにとどまりません。
対応言語数より現地での正確さを見る
日本語の利用者にとっても、AIを海外へ広げる際には、対応言語数より現地での正確さ、音声の扱い、問い合わせ先を確認する必要があります。企業は自社の音声データを学習に提供する前に、同意の範囲、保存期間、二次利用、誤認識時の人による補完を決めることで、導入後のトラブルを減らせます。 今回の発表は複数組織による方針と初期の重点領域の説明です。対象言語、提供時期、性能基準、個別サービスへの実装は公表されていません。低資源言語のデータを増やすことと、各地域で安全かつ公正に利用できることは別の検証項目です。