Sakana AIは10月12日、AIが複数の役割で協働し、その経験から同じモデルを改善する研究「MASS」を発表しました。研究向けの評価では、出力する文章量あたりの成績が改善したと報告しています。ただし、自己評価だけでは共通の誤りを見逃す恐れがあり、人が検証できる仕組みも重要です。
解く・改善する・評価するを同じモデルで
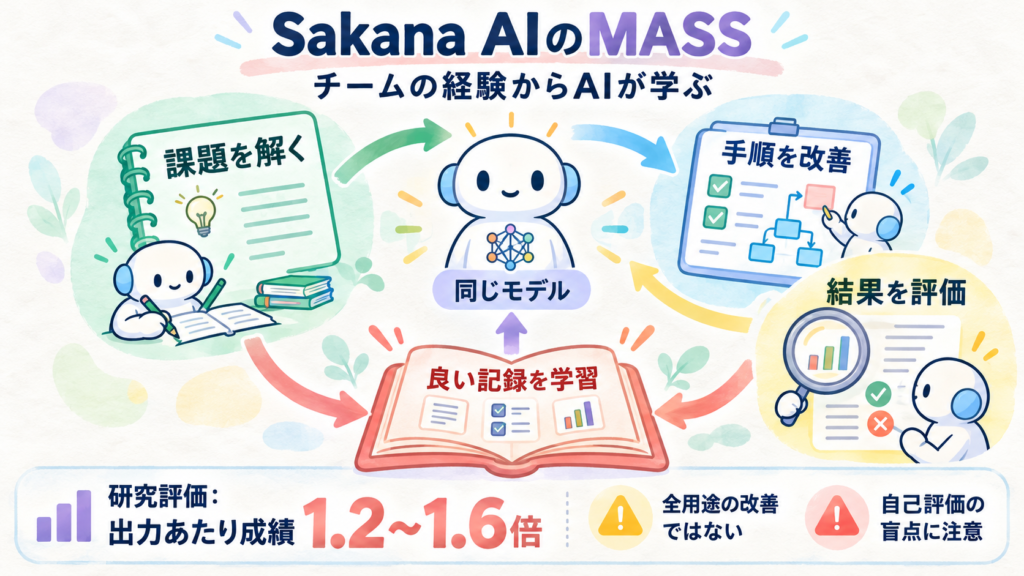
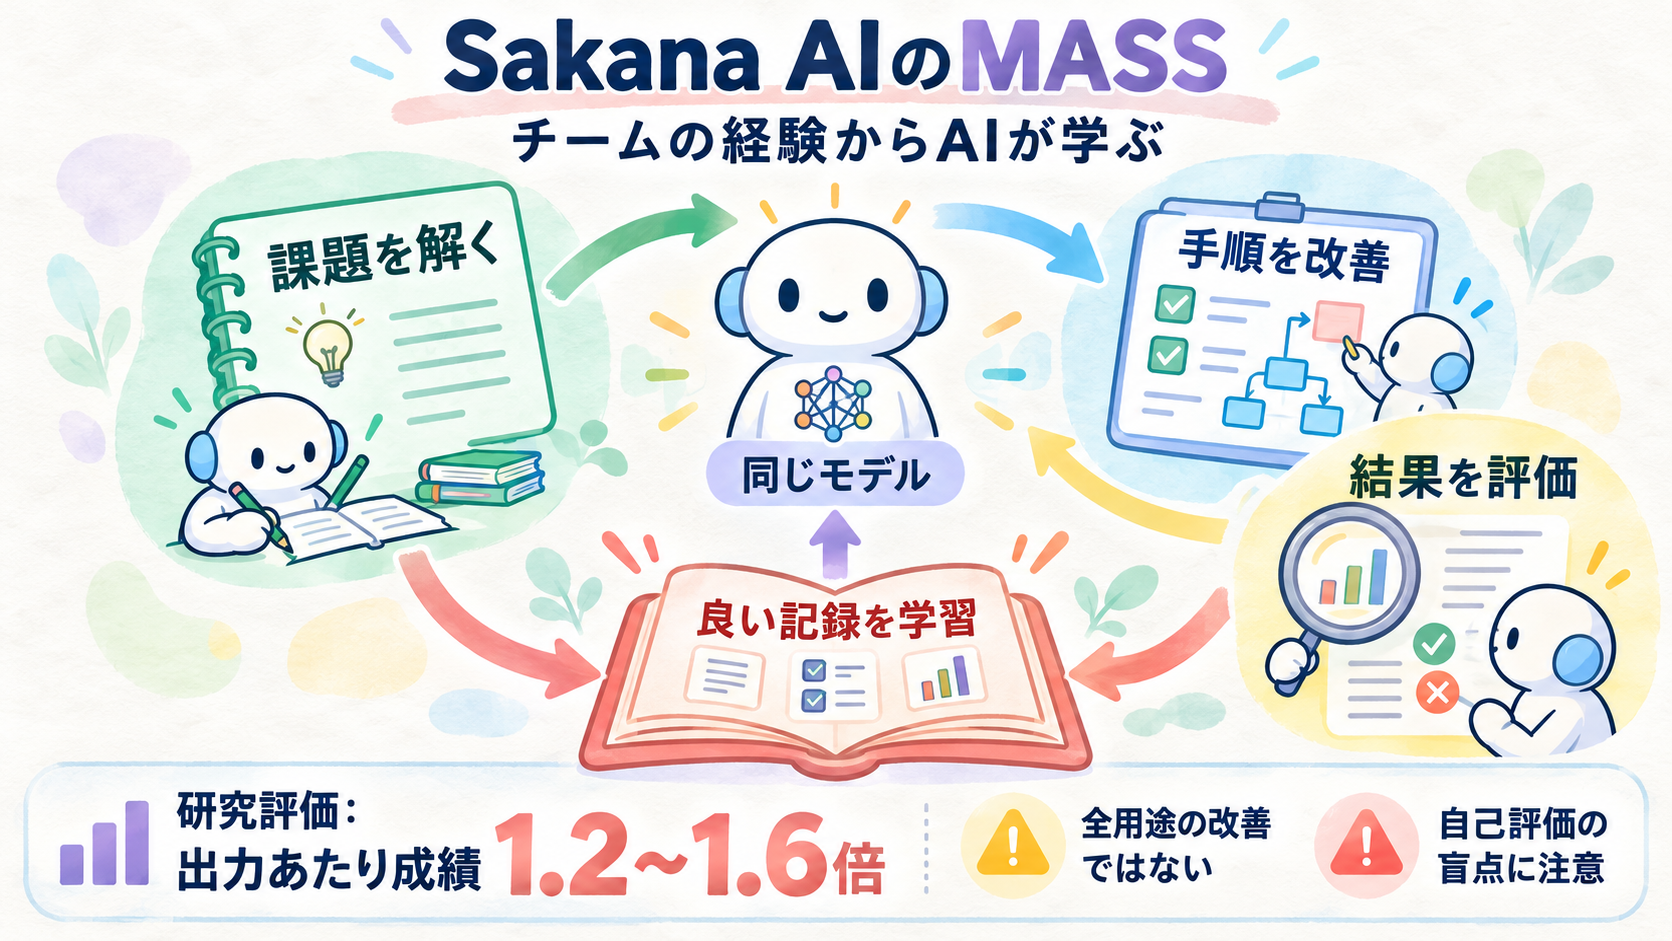
一つのモデルが、課題を解く役、作業の進め方を改善する役、結果を評価する役を担います。チームの手順を探索し、モデル自身が選んだ良い実行記録を学習に使います。改善後のモデルが再び三つの役割を担う循環です。論文は10月8日に投稿済みで、12日は同社による紹介の公開日です。
研究向けの効率は改善、全用途ではない
実験は270億パラメータのモデルで、この循環を2回実行しました。四つの研究向けベンチマークで、出力トークンあたりの成績は元のモデルの1.2〜1.6倍になったとしています。一方、ソフトウェア開発向けの別の評価では同じ指標が改善せず、あらゆる仕事で性能が上がったわけではありません。
自己評価の誤りを検出できる仕組みへ
編集部の見方として、AI活用の改善はモデルの大型化だけでなく、役割分担や確認手順の設計からも生まれる可能性があります。ただし、チームの記録を作り、選び、学習する工程には費用がかかります。今回の数字を、そのまま業務の処理速度や利用料金の改善率として読むべきではありません。 これは限られた研究課題での実験で、一般向けの完成サービスや、無制限の自己進化を実証した発表ではありません。同じモデルが作成と採点を担うと、誤りを良い成果と判断して学習に取り込む危険があります。独立した検証や、人が介入できる条件を残す必要があります。