
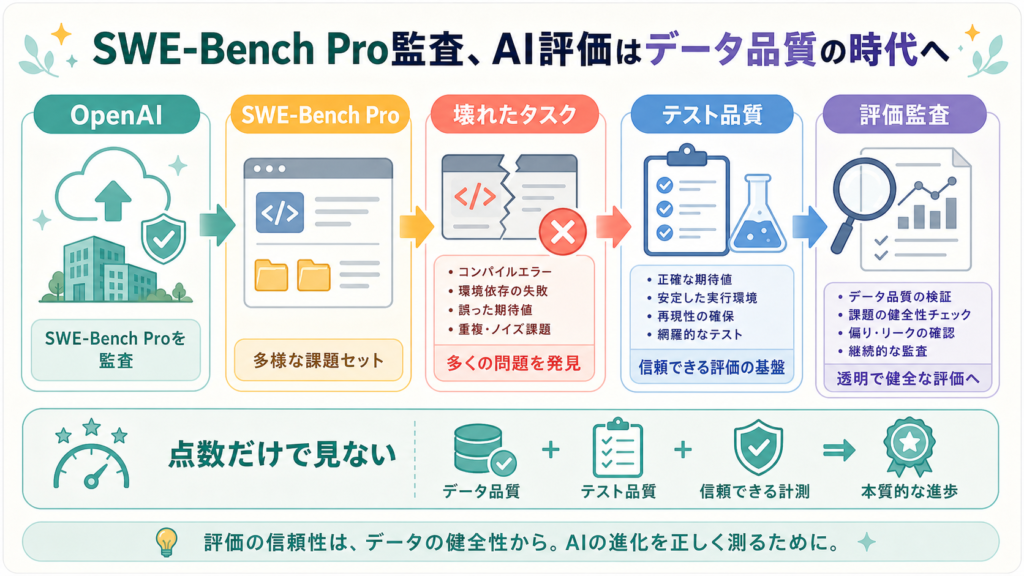
SWE-Bench Pro監査、AI評価はデータ品質の時代へ
OpenAIはSWE-Bench Proを詳細に監査し、公開タスクの約3割に壊れた課題があると推定しました。AIモデルの性能比較はベンチマークの点数だけでなく、問題文、テスト、採点...
毎朝6時に、AIともう1分野の2本が届きます。
AI は毎日 1 本。
7/6 – 7/12 の週
3本 OpenAIはSWE-Bench Proを詳細に監査し、公開タスクの約3割に壊れた課題があると推定しました。AIモデルの性能比較はベンチマークの点数だけでなく、問題文、テスト、採点...
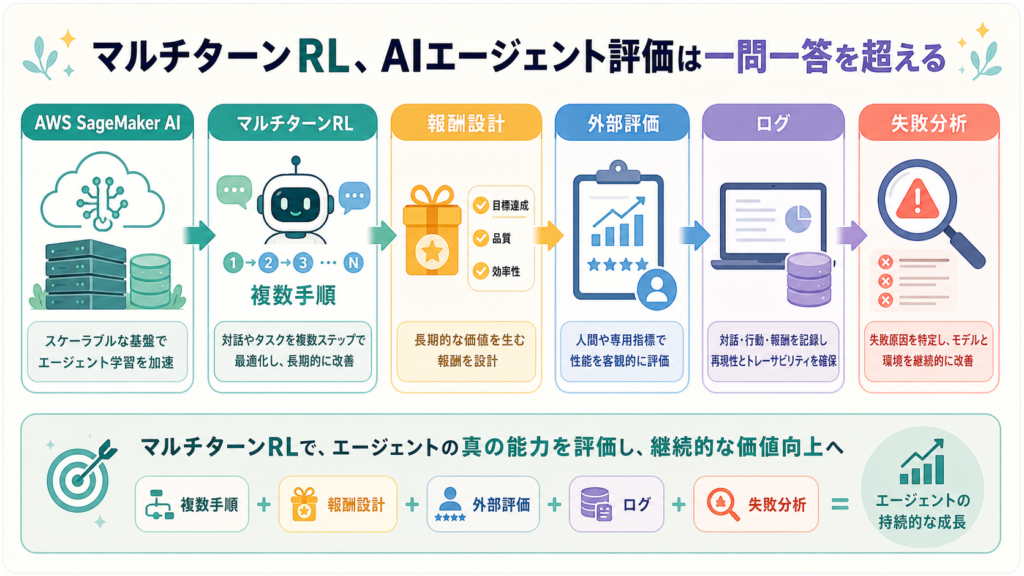
AWSはSageMaker AIでのマルチターン強化学習の実務ポイントを整理し、AIエージェント開発が一問一答の精度から、複数手順を通じた目標達成へ移っていることを示しました。評価...
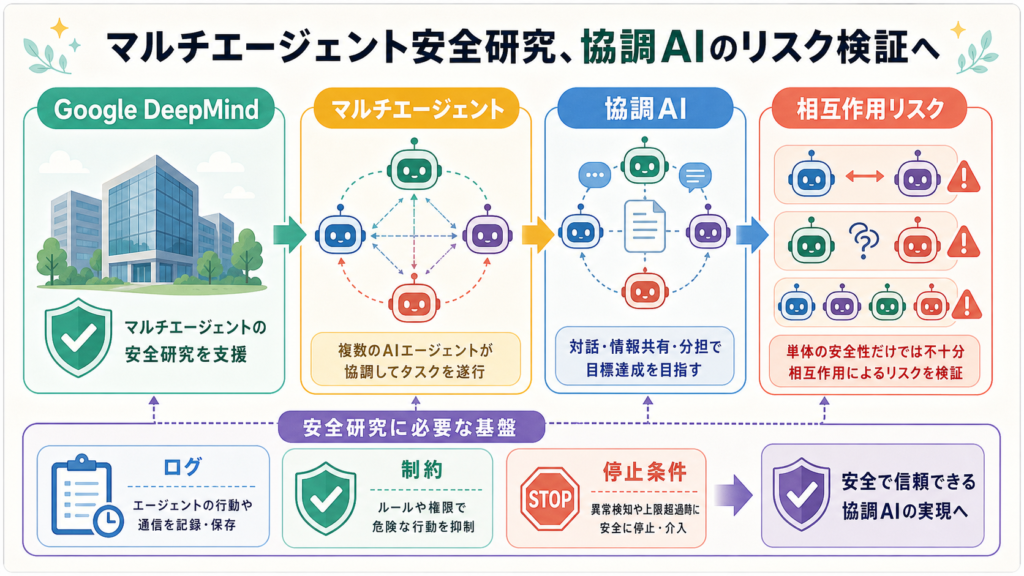
Google DeepMindらのマルチエージェントAI安全研究支援は、AIが単体で答える段階から、複数エージェントが協調・競争する段階のリスクへ研究対象が広がっていることを示しま...